
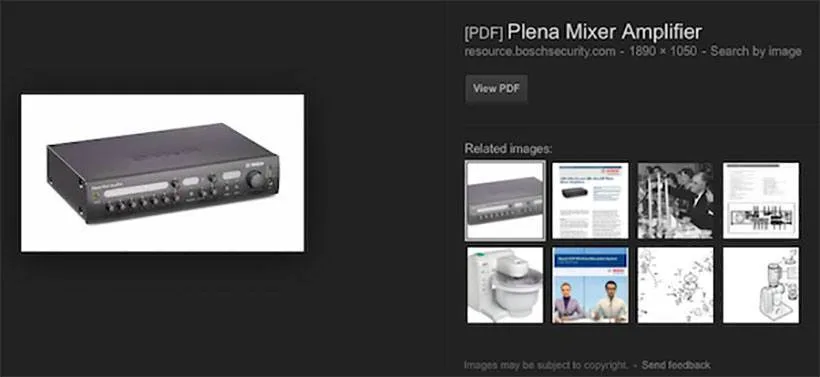
Google’ın internetteki her şeyi dizinlemeyi istediği bir sır değil. Arama devi, dizinleme kapasitesini optimize etmek adına büyük paralar harcıyor. Çabalarının karşılığını alıyor gibi gözüken Google, şimdi de taranmış PDF dosyalarında bulunan resimleri dizinliyor.
İLGİNİZİ ÇEKEBİLİR
Google Beam altı ülkede satılıyor, ortak ofislere açılıyor

Google Chrome’da yarım bıraktığınız sayfaya diğer cihazda devam edebileceksiniz

Google, konuşurken yüz ifadesi üreten Gemini Live Avatar’ı duyurdu
Google’ın PageBreak ajanı 500’den fazla XSS açığı buldu
Google, yapay zekâ çipini gelecek hafta uzayda deneyecek
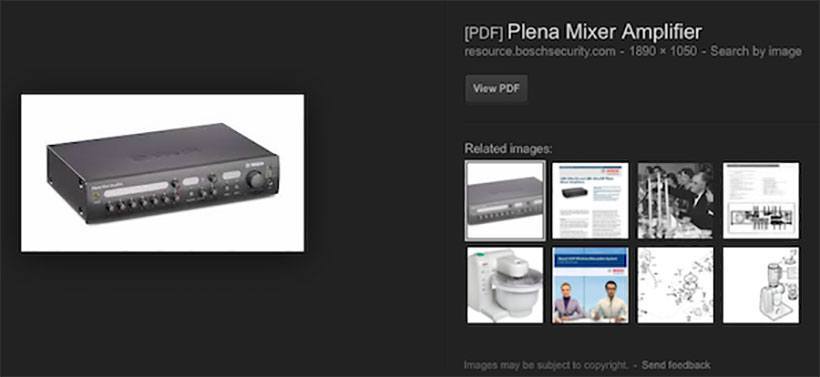
PDF dosyalarından gelen resimler, Google arama motorunun görsel arama bölümünde “PDF” damgasıyla gösteriliyor. Resmin yanına yerleştirilen bir bağlantı, kullanıcıları doğrudan söz konusu görselin bulunduğu PDF dosyasına yönlendiriyor.
Google’ın böyle bir yol seçmesinin nedeni, PDF dosyasındaki bir görsele doğrudan bağlantı vermenin mümkün olmaması. Dolayısıyla kullanıcıların ön izlemenin ardından resmi görmek için PDF dosyasını açması gerekiyor. Google, taranan PDF dosyalarındaki metinleri dizinlemek için 2008’den bu yana OCR teknolojisinden faydalanıyor.
Resimlerin ayıklanabilmeleri ve aranabilir olmaları, PDF’lerin aranabilmesinden sonraki adımı teşkil ediyor. Google’ın OCR teknolojisi, dünyanın dört bir yanından 200’ü aşkın dili tanıma kapasitesine sahip.
Günün Öne Çıkan Fırsatları

REKLAM — Bu içerikte satış ortaklığı bağlantıları bulunmaktadır. Bu bağlantılar üzerinden yapılan alışverişlerden Teknoblog komisyon kazanabilir.
